 ao3同人作品移动档案馆
01
多条件叠加检索
原作圈、登场角色、人物配对、题材标签、篇幅字数、完成状态可以逐层叠加。每加一个条件,结果集就实时收窄一次,比在几百页列表里翻找省力得多。
作品库越用越顺手的前提,是每一步筛选都算数。下面这些能力覆盖了从"想找一篇"到"读完并记住"的全过程。
原作圈、登场角色、人物配对、题材标签、篇幅字数、完成状态可以逐层叠加。每加一个条件,结果集就实时收窄一次,比在几百页列表里翻找省力得多。
点开任意一个标签,就能看到所有挂着它的作品,并在此基础上继续叠加筛选。标签既能用来"找想看的",也能放进排除项用来"避开不想看的"。
作品的分级、内容提醒与需要留意的情节会集中展示在简介上方。打开正文之前就能判断这篇是否适合自己,不必读进去才发现踩到了不想看的题材。
收藏是主动的,阅读记录是自动的。可以把"正在追""等完结""随时重温"分成不同归类,也可以什么都不做,让应用记住你上次停在哪一章。
网络好的时候把要看的章节缓存下来,通勤、出差、信号差的地方都能继续读。缓存按章节管理,读过的部分可以单独清理,不占多余空间。
多部曲、番外与合集会作为一个整体被跟进。作者更新后按既定顺序提示,不会出现先看后传、把剧情看乱的情况。
从启动到读完一篇,常用界面大致是这六个。可以左右拖动查看。
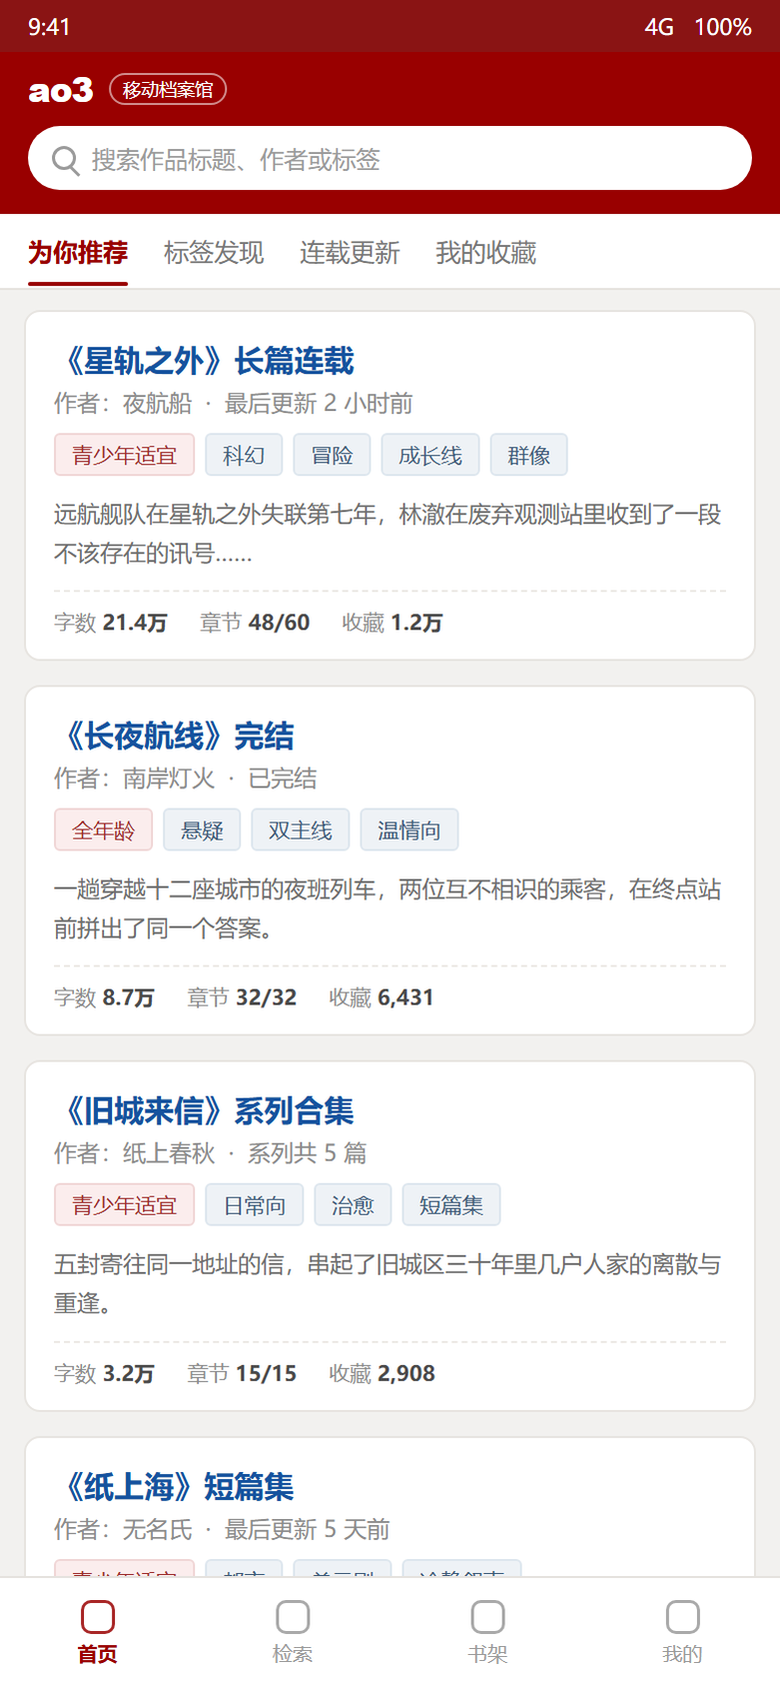
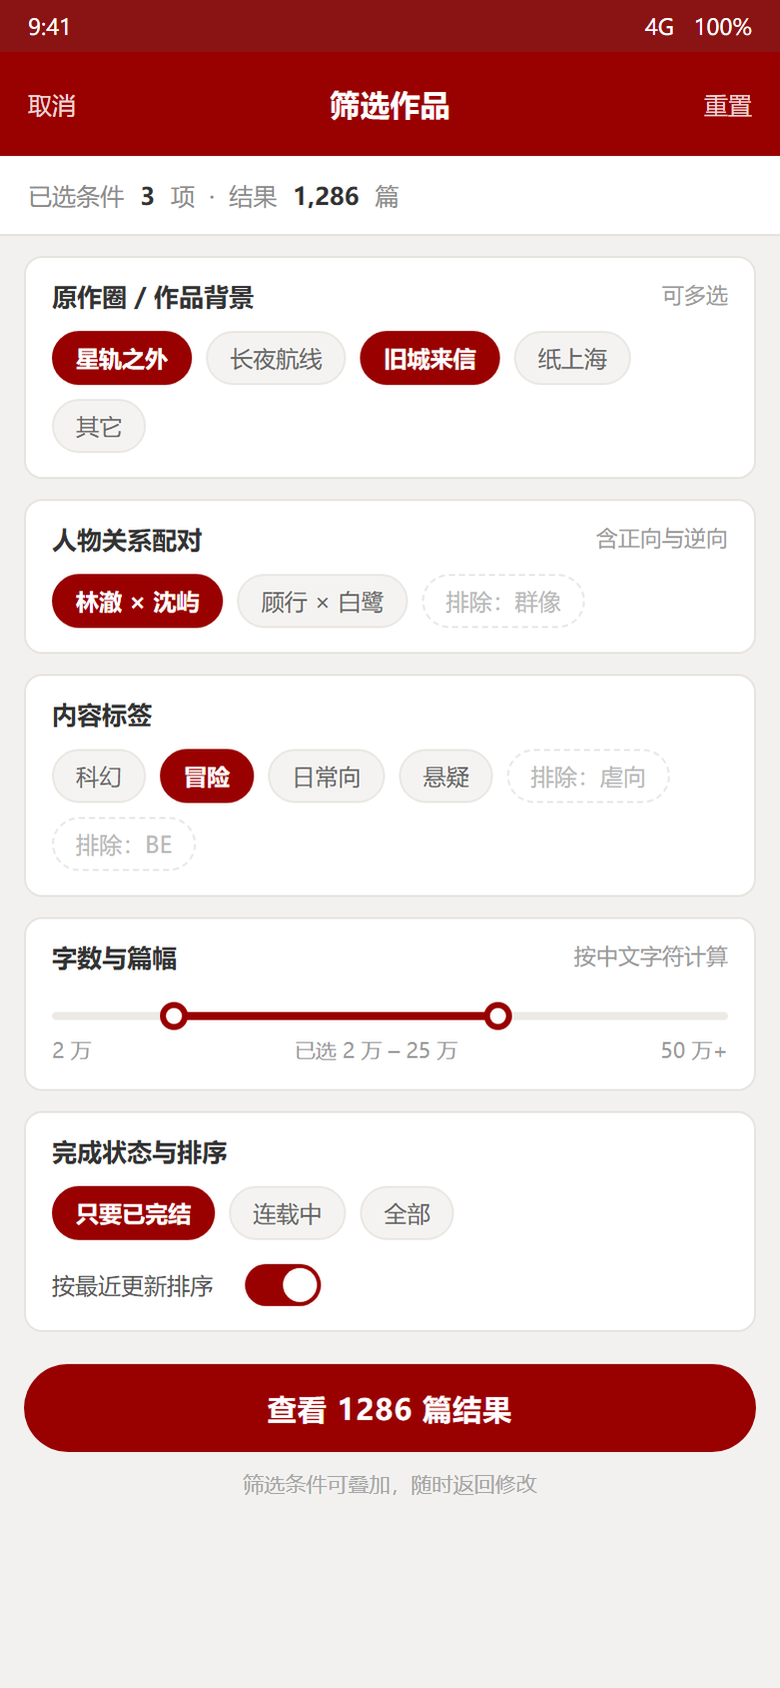
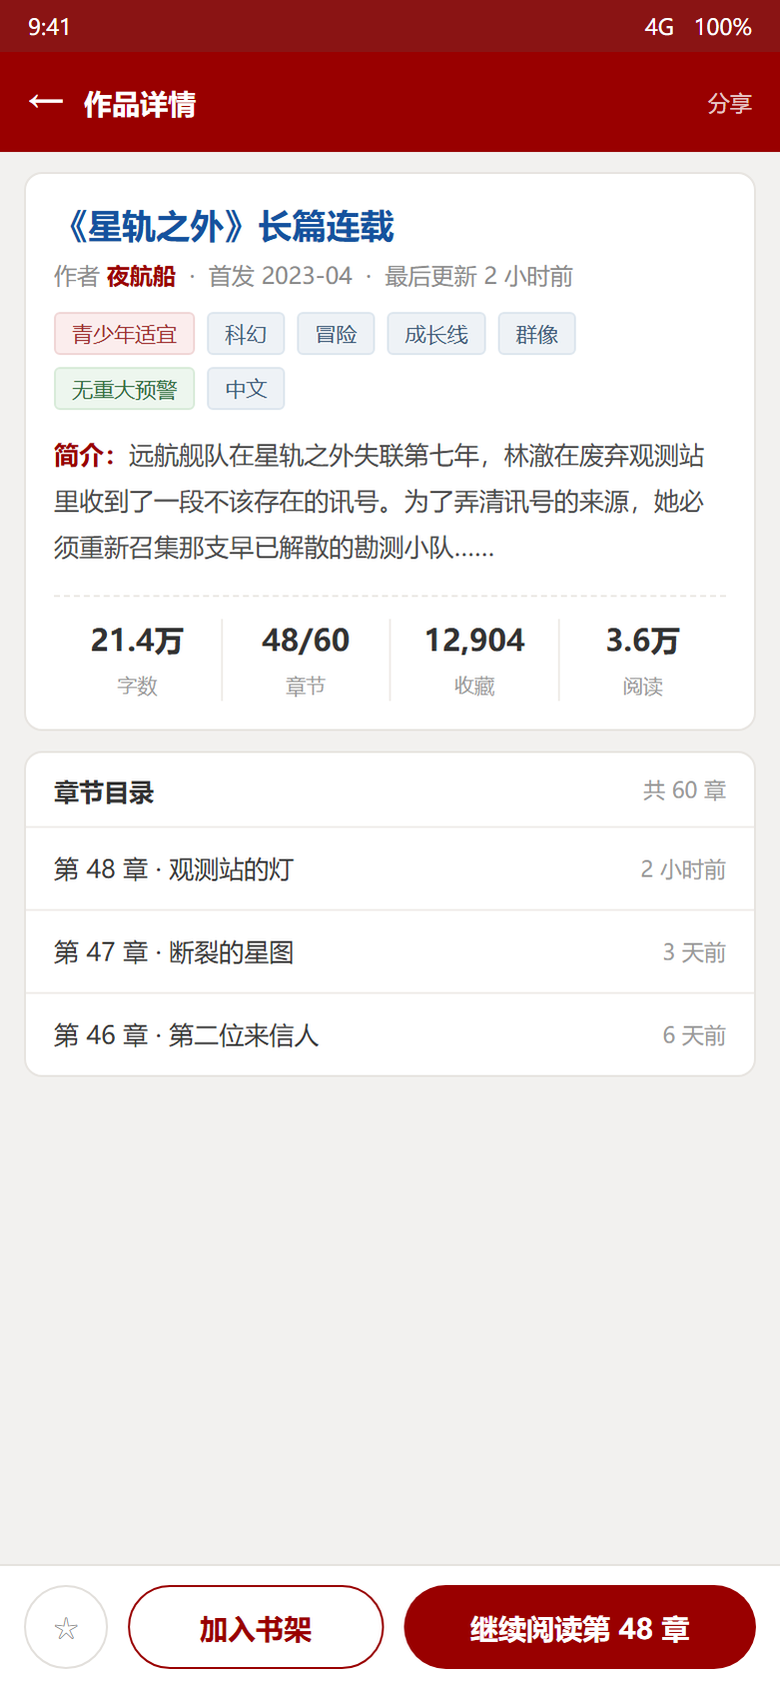
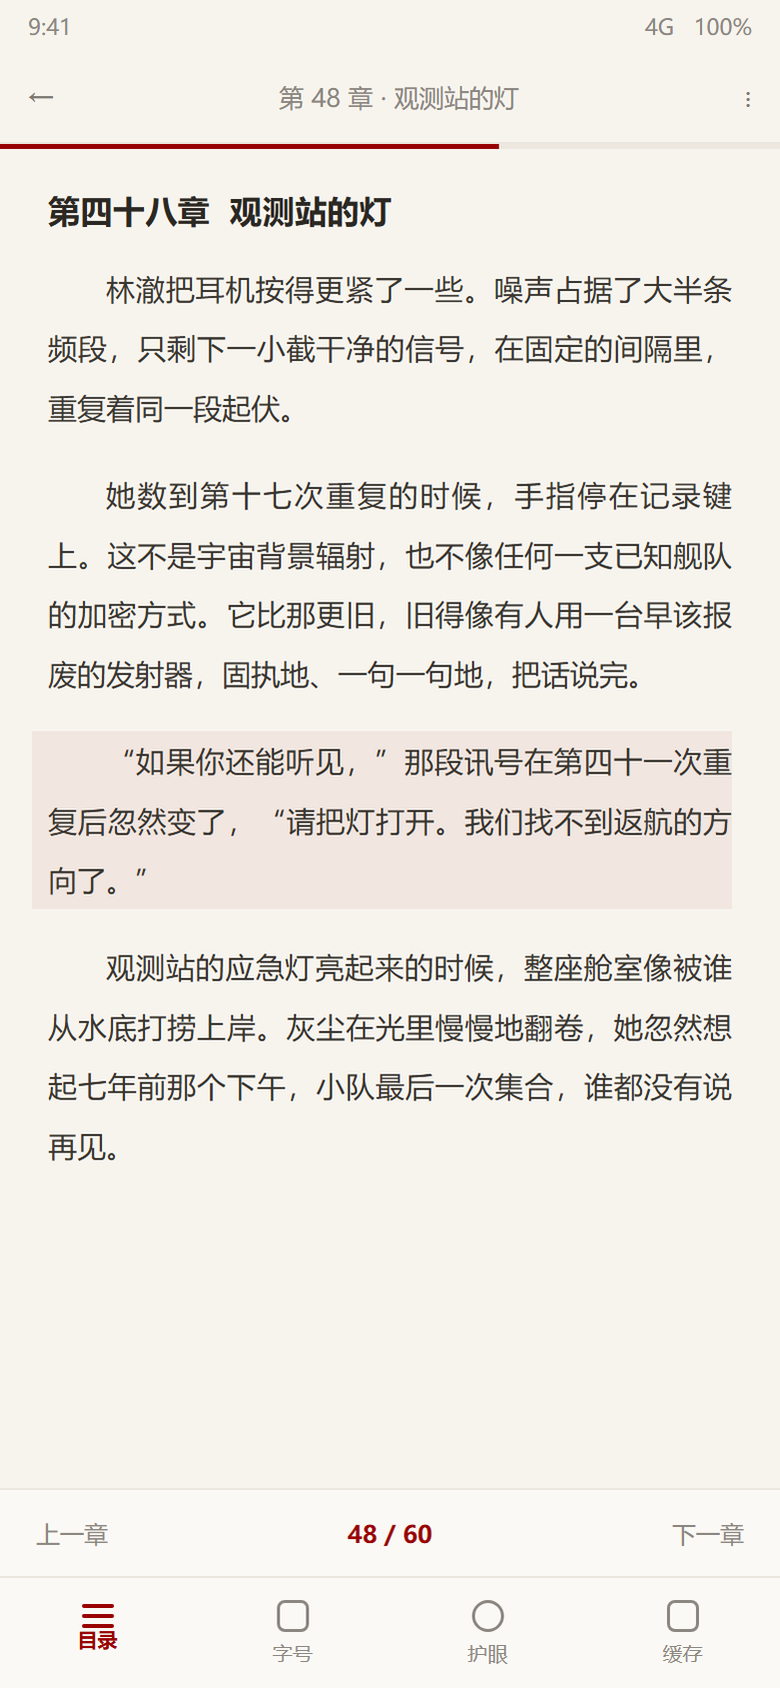
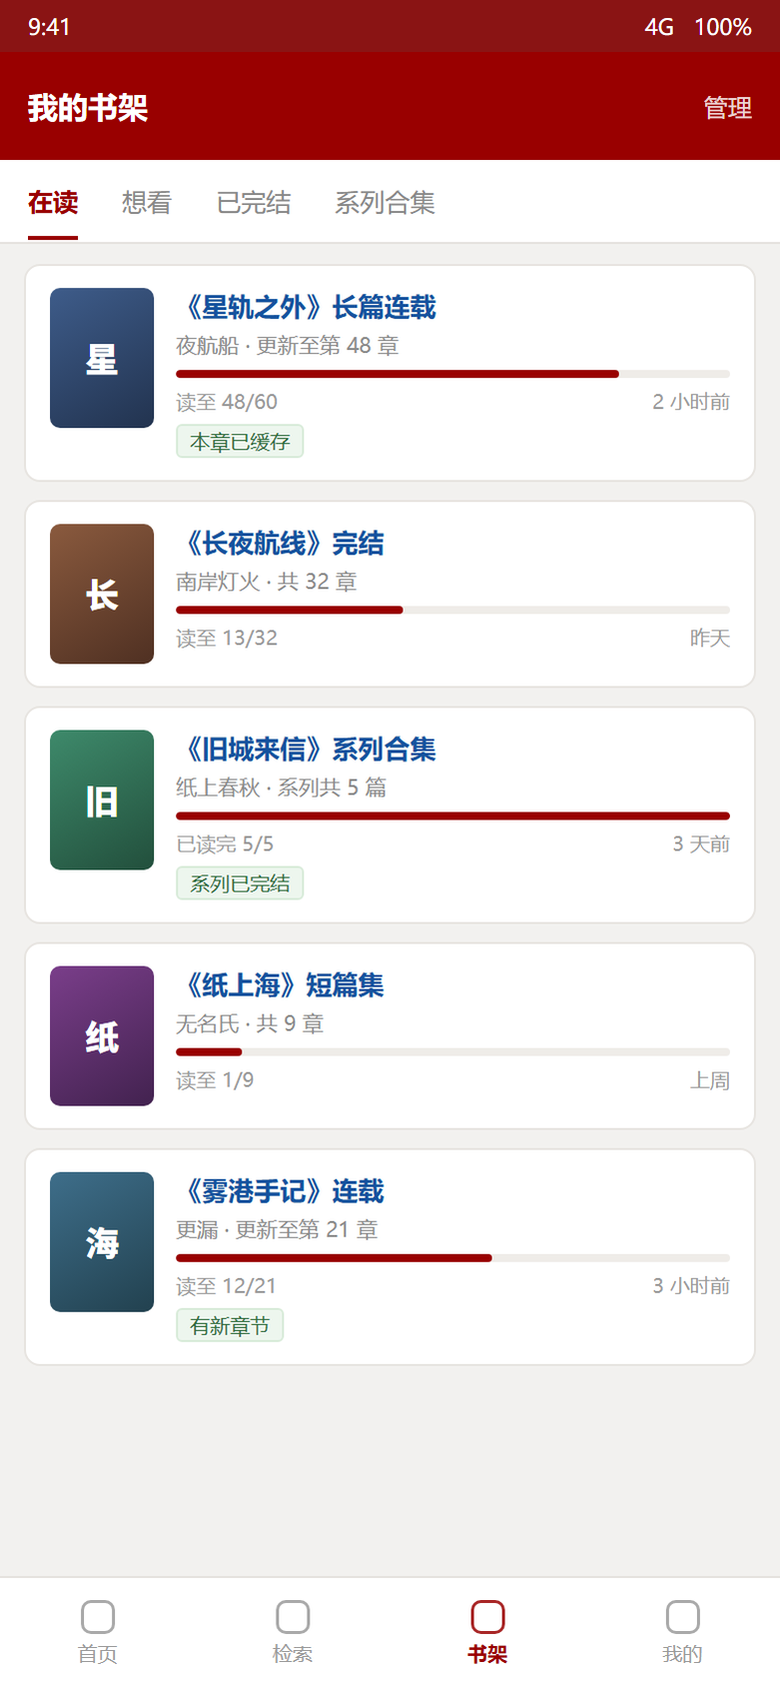
界面示意图仅用于说明功能位置,实际排布以应用内当前版本为准。
功能看得懂只是第一步。这几篇把条件怎么叠、缓存怎么留、出问题怎么排查写清楚了。
来自长期使用者的整理,侧重那些"用久才会发现"的细节。
以前找文全靠别人推荐,现在先锁原作圈再叠配对,最后按字数卡一道,几步就能把范围收到二十篇以内,翻起来轻松很多。
最看重的是排除功能。把不看的题材一次性排除掉,之后每次检索结果都干净,不用一篇篇点开再退出来。
出差路上信号不好,提前缓存了三十多章,飞机上照样看。缓存是按章存的,读完可以只清掉前面的部分。
追的多部曲会整组跟在书架里,更新后按顺序提示,不会出现先看到后传再回头补前传的尴尬。
阅读记录是自动留的,这点很省心。有次换手机重新登录,进度接上了,没有从头翻章节。
简介上方的分级和提醒写得很清楚,读之前就知道这篇大概是什么调性,省掉很多试错。
这里先列最常被问到的四条,完整版本收录在问题解答页。
以同人小说为主,同时容纳同人画作、有声作品、诗歌与剧本等变形创作。作品以"原作圈 + 角色 + 配对 + 标签"的组织方式归档,因此同一个原作下往往能同时找到长篇连载和几百字的单元短篇。
想了解标签体系怎么运作,可以看 核心功能拆解。
建议先锁定一个最熟悉的原作圈,再叠加人物配对,最后按字数或完成状态收尾。三层条件下来结果通常只剩几页,比一上来就用宽泛词搜索有效得多。完整流程见 新手上手路线。
可以。在有网络时把准备读的章节加入缓存,之后即使断网也能正常翻页。缓存按章节独立存放,读完之后可以只清理已读完的部分。具体策略见 离线与阅读体验。
不是继续往下翻,而是回头加条件。先补充"必须包含"的标签,再把不看的题材放进排除项,最后用字数区间做一次收尾。条件越具体,第一页的质量就越高。更多检索技巧见 常见问题排查。